A/B 테스트에서 유의미한 결과가 보인다고 즉시 멈춰도 되는 것은 아니다. 정해 둔 표본을 채우는 분석인지, 반복 확인을 반영한 순차 분석인지에 따라 종료 규칙이 다르다. 결과를 본 뒤 유리한 규칙을 고르면 판단이 왜곡될 수 있다.
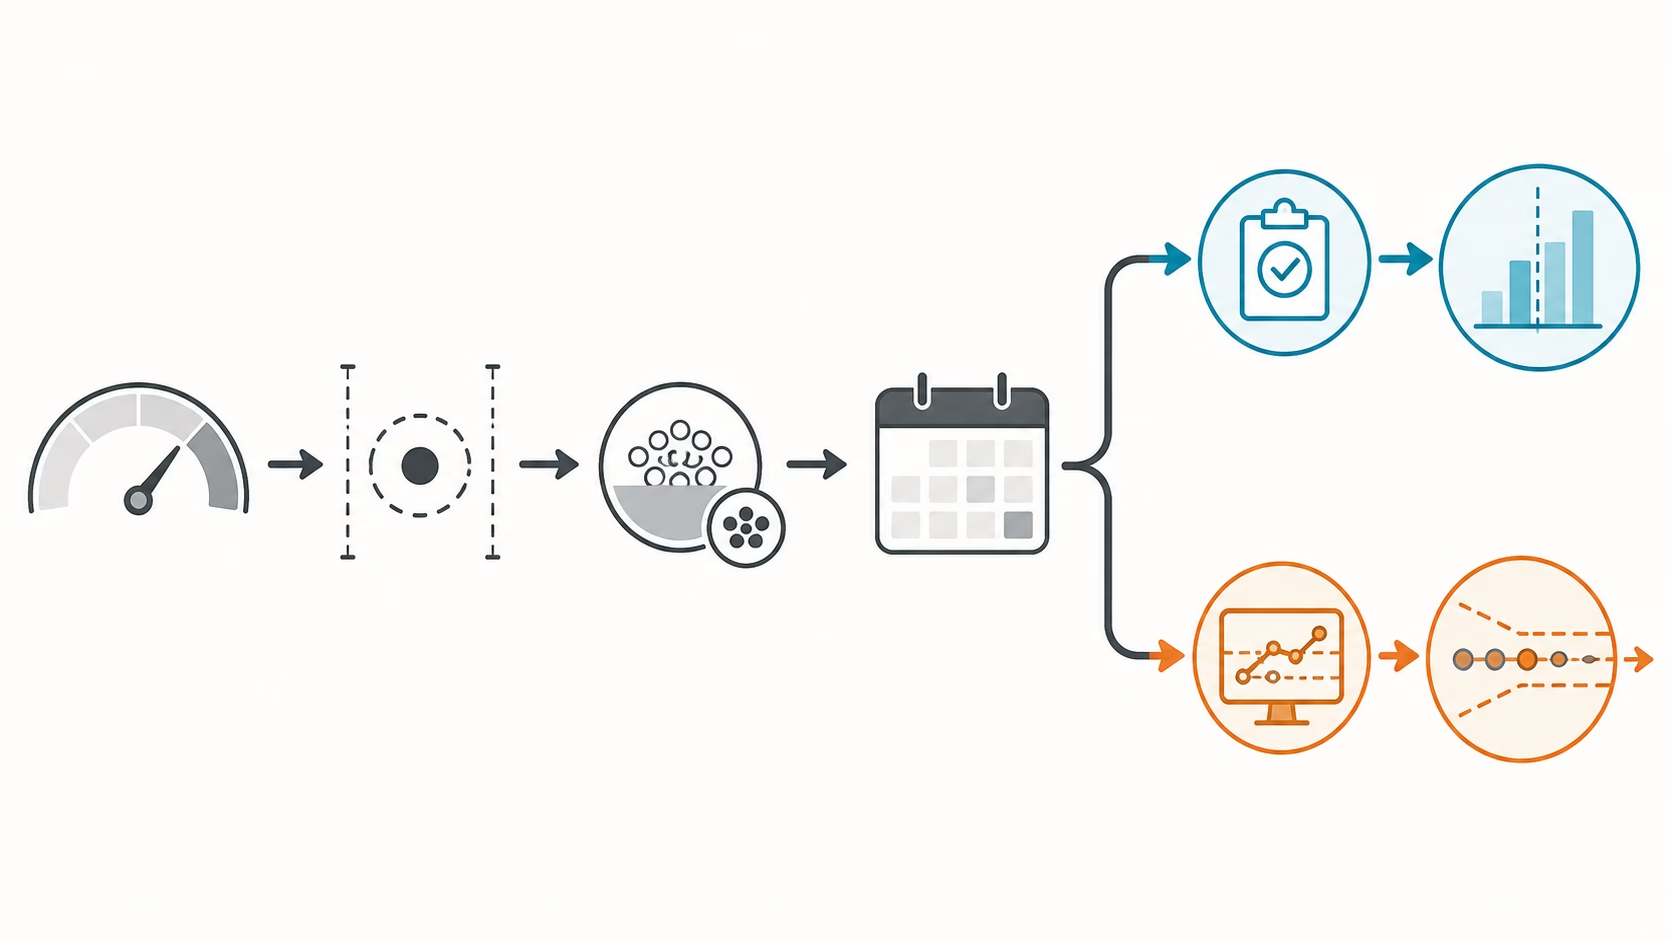
종료 규칙을 정한 다음에는 기준 전환율, 사업적으로 의미 있는 최소 변화량(MDE), 유의수준, 검정력, 변형 수와 유입량을 연결해 필요한 표본을 구한다. 표본을 다 모아도 전환이 늦게 확정되거나 요일별 행동을 관찰해야 한다면 최종 판단 시점은 뒤로 밀린다. 종료일은 설계의 입력값이 아니라 여러 조건을 반영한 결과다.
중간 결과를 볼 방식부터 선택한다
고정표본 방식에서는 목표 표본수와 분석 시점을 시작 전에 정한다. 매일 p값을 확인하다가 유의해진 날에만 멈추면 애초에 정한 오류율을 지키기 어렵다. 핵클의 표본수 계산기 안내도 사전 계획 없이 유의해진 시점만 골라 종료하지 말아야 한다고 설명한다.
중간 판단이 꼭 필요하다면 사용하는 도구가 어떤 순차 분석을 제공하고, 반복 확인에 따른 오류를 어떻게 통제하는지 확인해야 한다. Spotify Confidence의 순차 검정 문서는 예상 표본수가 있을 때 사용할 수 있는 group sequential 방식과 예상 표본수가 없어도 쓸 수 있는 always-valid 방식을 구분한다. 전자는 더 높은 검정력을 낼 수 있고, 후자는 효과를 검출하기가 더 어려울 수 있다. 같은 ‘순차 분석’이라는 이름을 쓰더라도 도구별 구현과 보장은 같지 않다.
MDE는 표본 계획과 사업 판단을 잇는다
MDE는 계획한 조건에서 검출하려는 최소 효과 크기다. 실험에서는 이 값을 사업적으로 의미 있는 변화량과 연결해야 한다. 기준 전환율이 10%일 때 상대 2% 개선은 10%에서 10.2%로 오르는 변화지만, 2%포인트 개선은 12%가 되는 변화다. 절대 변화와 상대 변화를 구분하지 않으면 표본수 계산과 출시 판단이 서로 다른 효과를 가리킨다.
MDE를 작게 잡을수록 필요한 표본과 기간은 커진다. AB Tasty의 MDE 계산기 안내는 방문자 수, 기준 전환율, 변형 수 등을 이용해 목표 기간에 검출 가능한 효과를 사전에 확인하도록 안내한다. 다만 계산기가 사업적으로 감수할 수 있는 기준까지 정해 주지는 않는다. 예상 매출과 마진, 운영 비용, 사용자 불편을 함께 검토해 계획값을 정해야 한다.
기준 전환율은 최근 데이터 가운데 유입 경로, 기기, 국가, 캠페인 조건이 비슷한 구간에서 가져오는 편이 안전하다. 과거 데이터가 부족하거나 측정이 불안정하다면 AB Tasty 문서가 제안하듯 A와 A를 나누는 실험으로 측정 체계를 점검하거나 설계를 수정할 수 있다. A/B 테스트 표본수 계산 실무 연구가 지적하듯 절대·상대 효과의 구분과 관측값 사이의 상관관계도 표본수에 영향을 준다. 이 연구는 사전공개 논문이므로, 실제 적용 때는 지표와 무작위 배정 단위에 맞는지 별도로 검증해야 한다.
표본수는 조건을 붙여 날짜로 바꾼다
계산기가 산출한 군별 필요 표본을 n, 하루 적격 순 사용자를 u, 해당 변형의 배정 비율을 q라고 하자. 유입이 일정하다는 단순 가정에서는 표본 수집 기간을 n ÷ (u × q)일로 추정할 수 있다. 두 변형을 50대 50으로 나누면 각 군의 q는 0.5다. 계산기 결과가 군별 표본인지 전체 표본인지, 유입량과 표본수가 같은 단위인지 먼저 확인해야 한다.
이 계산값이 곧바로 결과 확정일을 뜻하지는 않는다. 표본을 모은 뒤에도 전환이 확정되는 관측 창이 남을 수 있다. 반복 행동이나 요일 효과를 확인하려면 필요한 사업 주기도 지나야 한다. 유입 변동과 제외될 사용자 역시 기간에 영향을 준다.
식에는 사용자별 관측이 서로 독립적이고 무작위 배정과 로그 수집이 정상이라는 가정도 들어 있다. 매장이나 조직처럼 클러스터 단위로 배정하거나 사용자끼리 영향을 주는 실험이라면 일반적인 전환율 계산기의 표본을 그대로 기간으로 환산하기 어렵다. 저장된 조사 자료는 이런 설계의 계산법까지 제공하지 않으므로 별도 통계 설계가 필요하다.
중간에는 승패보다 데이터 이상을 찾는다
고정표본 실험도 운영 상태는 중간에 점검할 수 있다. 다만 승패를 선언하는 대신 계획한 배정 비율에서 크게 벗어난 SRM(sample ratio mismatch), 로그 누락, 노출과 전환의 연결 오류, 가드레일 악화를 확인한다. Microsoft Research의 실험 운영 지침은 SRM을 결과의 신뢰성을 훼손할 수 있는 조기 경보로 보고, 성공 지표와 함께 데이터 품질·가드레일·진단 지표를 관찰하도록 제시한다.
가드레일은 주지표가 좋아져도 일정 수준 이상 악화되면 출시를 보류할 보호 지표다. 구매 전환이 올라도 오류율, 취소율, 지원 문의처럼 미리 정한 지표가 허용 범위를 넘으면 성공으로 확정하기 어렵다. 결측이나 SRM이 발견됐다면 유의한 차이가 나왔더라도 배정과 집계 문제를 고친 뒤 실험을 다시 설계하는 편이 안전하다.
종료 조건과 출시 조건을 함께 확인한다
출시·유지·중단은 p값 하나로 결정하지 않는다. 선택한 분석 방식의 종료 규칙을 지켰는지 먼저 확인하고, 데이터 품질과 가드레일을 점검한다. 그 뒤 효과 추정치와 불확실성 범위가 사전에 정한 사업 기준을 어느 정도 지지하는지 판단해야 한다.
순차 분석 결과를 고정표본 p값처럼 해석하거나, 고정표본 결과를 매일 확인한 뒤 순차 분석과 같은 효력이 있다고 간주해서는 안 된다. Optimizely의 통계 엔진 설명도 반복 확인을 반영한 통계량은 해당 순차 엔진의 기능이며, MDE는 유의성 선언 기준이 아니라 시간과 표본을 계획하는 입력값이라고 구분한다. 이 설명은 특정 제품의 구현에 관한 것이므로 다른 도구에도 같은 보장이 있다고 일반화할 수 없다.
실험 전에는 주지표와 분모, 절대·상대 MDE, 유의수준과 검정력, 표본수의 군별·전체 기준, 분석 방식, 중간 점검 항목, 가드레일, 전환 관측 창과 출시 기준을 기록해 둔다. 이 조건을 정하면 종료일은 단순히 표본이 차는 날이 아니라, 계획한 분석과 데이터 품질을 바탕으로 결정을 내릴 수 있는 날이 된다.
참고 자료
- 핵클, 「A/B 테스트 샘플 사이즈 계산기」
- AB Tasty, 「How to use MDE Calculator」
- Spotify Confidence, 「Sequential Tests」
- Optimizely, 「Stats Engine: How Statistical Decisions Work」
- Microsoft Research, 「Patterns of Trustworthy Experimentation: During-Experiment Stage」
- arXiv, 「All about sample-size calculations for A/B testing: Novel extensions and practical guide」