두 값만 가장 많이 나타났다면 최빈값은 두 개다. 그러나 모든 값의 빈도가 같을 때는 정의의 적용 방식과 교육상의 명명 관례가 갈린다. 모든 값이 빈도함수의 최댓값을 달성하지만, 일부 교재는 어느 값도 더 흔하지 않다는 이유로 ‘최빈값이 없다’고 부른다.
둘 중 하나만 정답이라고 단정하기보다 계산 결과와 해석을 나눠 쓰는 편이 정확하다. 모든 값이 동률이라면 “모든 값이 최대 빈도를 달성하지만, 대표성이 있는 뚜렷한 최빈값은 없다”고 보고할 수 있다.
일부 값만 공동 1위라면 모두 최빈값이다
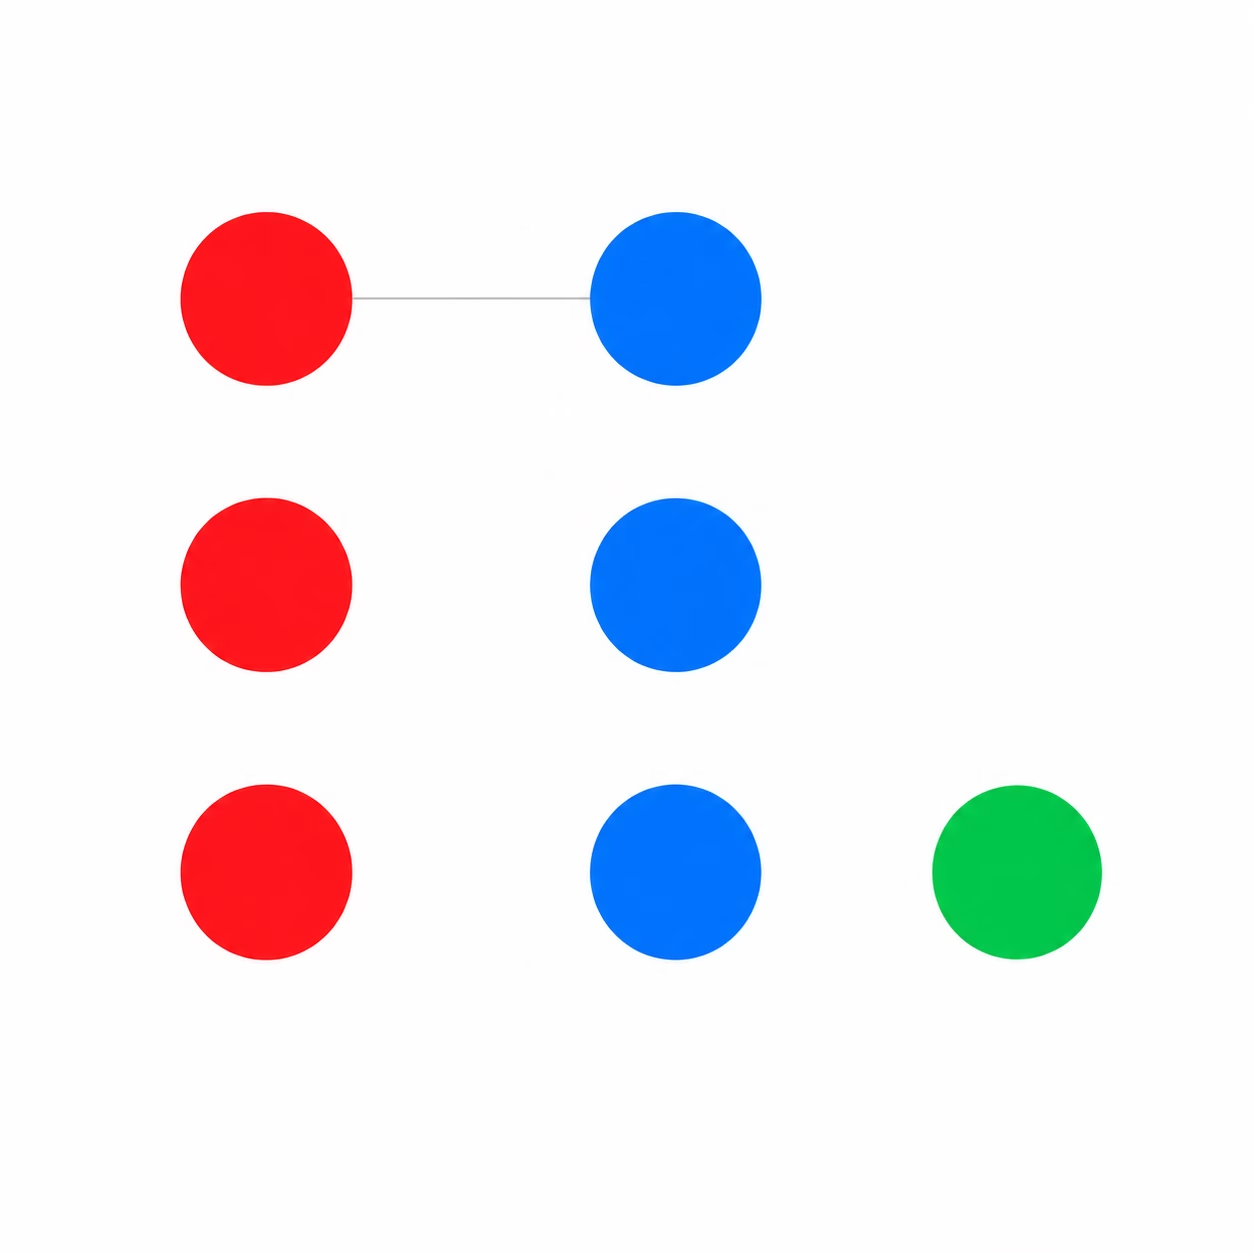
최빈값은 빈도수가 아니라 가장 높은 빈도를 가진 값 또는 범주다. 예를 들어 ‘빨강, 빨강, 빨강, 파랑, 파랑, 파랑, 초록’에서는 빨강과 파랑이 각각 3회, 초록이 1회 나타난다. Virginia Tech 공개교재의 정의를 적용하면 빨강과 파랑을 모두 최빈값으로 남겨야 한다.
3회
3회
1회
최고 빈도는 3회이고 전체 관측값은 7개다. 빨강과 파랑의 비율은 각각 3÷7, 약 42.9%다. 이는 예시 자료를 단순 집계한 결과일 뿐 모집단 비율의 추정치는 아니다. 표본도 작아서 관측값 하나가 추가되면 동률이 쉽게 풀린다.
둘 중 하나만 골라 쓰면 자료에 없던 우열을 만들게 된다. California State University, Dominguez Hills 강의자료도 최고 빈도를 공유한 두 값을 모두 mode로 제시한다. 이 자료는 이런 데이터 세트를 bimodal이라고 부르지만, 이 용어를 히스토그램의 두 봉우리와 곧바로 같은 뜻으로 받아들여서는 안 된다.
모든 값이 동률이면 계산 결과와 명명이 갈린다
‘서울, 부산, 대구’가 각각 한 번씩 나온 자료에서 빈도함수 f(x)의 최댓값은 1이다. 세 범주 모두 이 값을 달성하므로 최대화 원소의 집합, 즉 argmax에는 세 범주가 전부 들어간다. ‘A, A, B, B, C, C’처럼 각 값이 두 번씩 나온 자료도 같은 구조다.
다만 통계 교육에서는 이를 반드시 ‘세 개의 최빈값’이라고 부르지는 않는다. CSUDH 강의자료는 모든 값의 빈도가 같으면 관례상 최빈값이 없다고 명시한다. 최댓값을 달성한 값이 없다는 뜻이 아니라, 어느 값도 다른 값보다 더 자주 나타나지 않아 대표값으로 구별되지 않는다는 뜻이다.
유한 표본에서 빈도가 우연히 같아진 사실을 이론적 균등분포와 혼동해서도 안 된다. 세 범주가 한 번씩 관측됐다는 사실만으로 모집단에서 각 범주의 발생 확률이 같다고 결론 내릴 수는 없다. 일부 값만 공동 최고라면 “최빈값은 빨강과 파랑이며 각각 3회다”라고 쓰면 된다. 모든 고유값이 동률이라면 “모든 값이 최대 빈도를 달성하지만 뚜렷한 최빈값은 없다”고 계산과 해석을 함께 밝히는 것이 안전하다. 특히 모든 값이 한 번씩만 나왔다면 반복 관측이 없어 대표성이 있는 최빈값을 정하기 어렵다는 조건도 덧붙일 수 있다.
도구가 값 하나를 반환해도 유일한 최빈값은 아니다
소프트웨어의 출력은 통계적 판단뿐 아니라 함수의 반환 형식에도 좌우된다. 같은 자료를 넣고도 어떤 함수는 값 하나를, 다른 함수는 공동 최고 빈도 값을 모두 보여준다.
Microsoft의 MODE 문서에 따르면 구형 MODE 함수는 가장 자주 나타난 숫자 하나를 반환하고, 중복된 숫자가 없으면 #N/A를 반환한다. 수치 자료에서 복수 결과를 보존하려면 MODE.MULT를 사용할 수 있다. Excel 함수는 텍스트, 논릿값, 빈 셀을 처리하는 규칙도 있으므로 분석하려던 원자료와 실제 계산 대상이 같은지 확인해야 한다.
Python statistics 공식 문서에서 mode()는 동률일 때 입력에서 먼저 나타난 값 하나를 반환한다. multimode()는 공동 최고 빈도 값을 처음 나타난 순서대로 모두 반환한다. 따라서 mode()가 ‘빨강’을 돌려줬다는 사실만으로 빨강이 유일한 최빈값이라고 보고할 수 없다.
SciPy의 mode 문서도 최빈값 하나와 그 빈도를 반환한다. 계산 축과 NaN 처리 정책에 따라 대상과 결과가 달라질 수 있다. Oracle STATS_MODE 문서는 동률 최빈값이 여럿이면 그중 하나만 선택한다고 밝히며, 전부 찾으려면 GROUP BY, COUNT, MAX를 결합한 별도 질의를 안내한다.
단일값 함수의 결과를 받았다면 값별 빈도표부터 다시 만든다. 최고 빈도와 같은 값을 모두 추출한 뒤 그 수가 전체 고유값 수와 같은지도 확인해야 한다. 둘이 같다면 모든 값이 최대 빈도를 공유한다는 계산 결과와 뚜렷한 최빈값이 없다는 해석을 함께 적는다.
공동 최빈값과 두 봉우리는 다른 판단이다
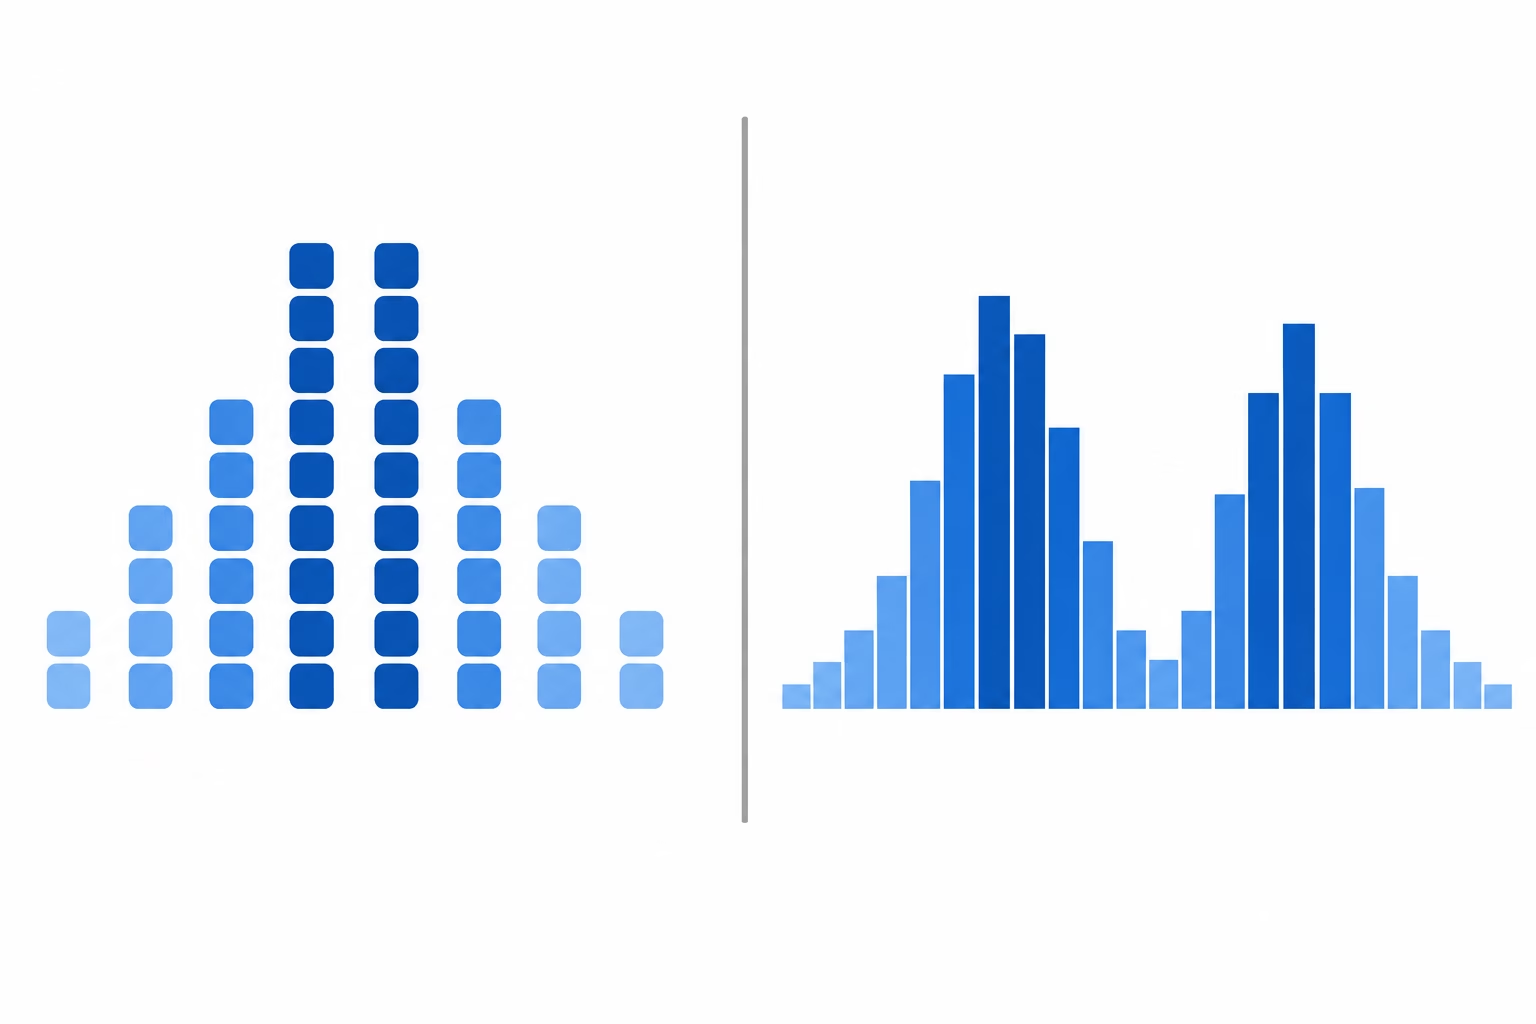
원자료의 두 값이 같은 최고 빈도를 가진 사실과 히스토그램에서 두 봉우리가 보이는 현상은 구분해야 한다. NIST/SEMATECH 통계 핸드북에서 bimodal은 히스토그램에 두 봉우리가 나타나는 분포 형태다. 이런 모양은 혼합집단이나 주기성 같은 생성 원인을 더 조사할 단서가 될 수 있다.
반면 ‘1, 1, 2, 2, 3’에서 1과 2가 공동 최빈값이라는 사실만으로 두 집단이 섞였다고 말할 수는 없다. 값이 인접해 있고 관측값도 다섯 개뿐이다. 연속형 자료의 히스토그램은 구간 폭과 경계에 따라 보이는 봉우리 수가 달라질 수도 있다. 값별 동률은 빈도표에서 확인하고, 분포의 봉우리는 동일한 구간 기준을 적용한 그래프로 살펴야 한다.
답안은 교재를 따르고 보고서는 관례를 밝힌다
정의 문제의 답안이라면 해당 수업이나 교재가 채택한 관례를 따르면 된다. 실제 분석에서는 그 관례를 숨기지 않는 편이 낫다. 일부 값만 최고 빈도를 공유하면 모두 제시하고, 모든 값이 동률이면 최대 빈도를 달성한 값은 전부지만 대표성이 있는 뚜렷한 최빈값은 없다고 밝힌다.
Excel MODE, Python mode(), SciPy mode, Oracle STATS_MODE처럼 하나만 반환하는 함수는 유일한 최빈값의 존재를 보장하지 않는다. 공동 최빈값을 보존하는 함수나 값별 빈도표로 재검산해야 한다. 복수 최빈값을 발견했더라도 이를 곧바로 두 봉우리나 혼합집단의 증거로 해석해서는 안 된다. 그런 판단에는 표본 크기와 히스토그램의 구간 기준을 포함한 추가 검토가 필요하다.
참고 자료
- Virginia Tech Publishing, 「2.6 Measures of Center」
- NIST/SEMATECH, 「Histogram Interpretation: Symmetric and Bimodal」
- California State University, Dominguez Hills, 「Introduction to Statistics」
- University of Utah Department of Sociology, 「Central Tendency & Variability」
- Microsoft Support, 「MODE function」
- Microsoft Support, 「MODE.MULT function」
- Python Software Foundation, 「statistics — Mathematical statistics functions」
- SciPy, 「scipy.stats.mode」
- Oracle, 「STATS_MODE」