정렬한 수치형 원자료가 짝수 개라면 두 가운데 값의 평균이 중앙값이다. 결과가 원자료에 없어도 오류가 아니다. 값이 6개라면 세 번째와 네 번째 값 사이에 중앙 위치가 생기므로, 두 값의 중간점을 하나의 중앙값으로 쓴다.
다만 숫자로 기록된 자료라고 해서 언제나 이 규칙을 적용할 수 있는 것은 아니다. 값 사이의 차이가 측정량으로 해석되는지, 결측값과 가중치를 어떻게 처리했는지부터 확인해야 한다.
짝수 개 자료의 중심은 두 값 사이에 있다
1.40, 2.15, 2.50, 2.70, 2.73, 4.02를 작은 순서로 놓아 보자. 2.50과 2.70 사이의 어느 값을 잡아도 그보다 작거나 같은 값과 크거나 같은 값이 각각 세 개씩 있다. 짝수 개 자료에서는 한 관측값이 아니라 이 구간이 중앙 위치가 된다.
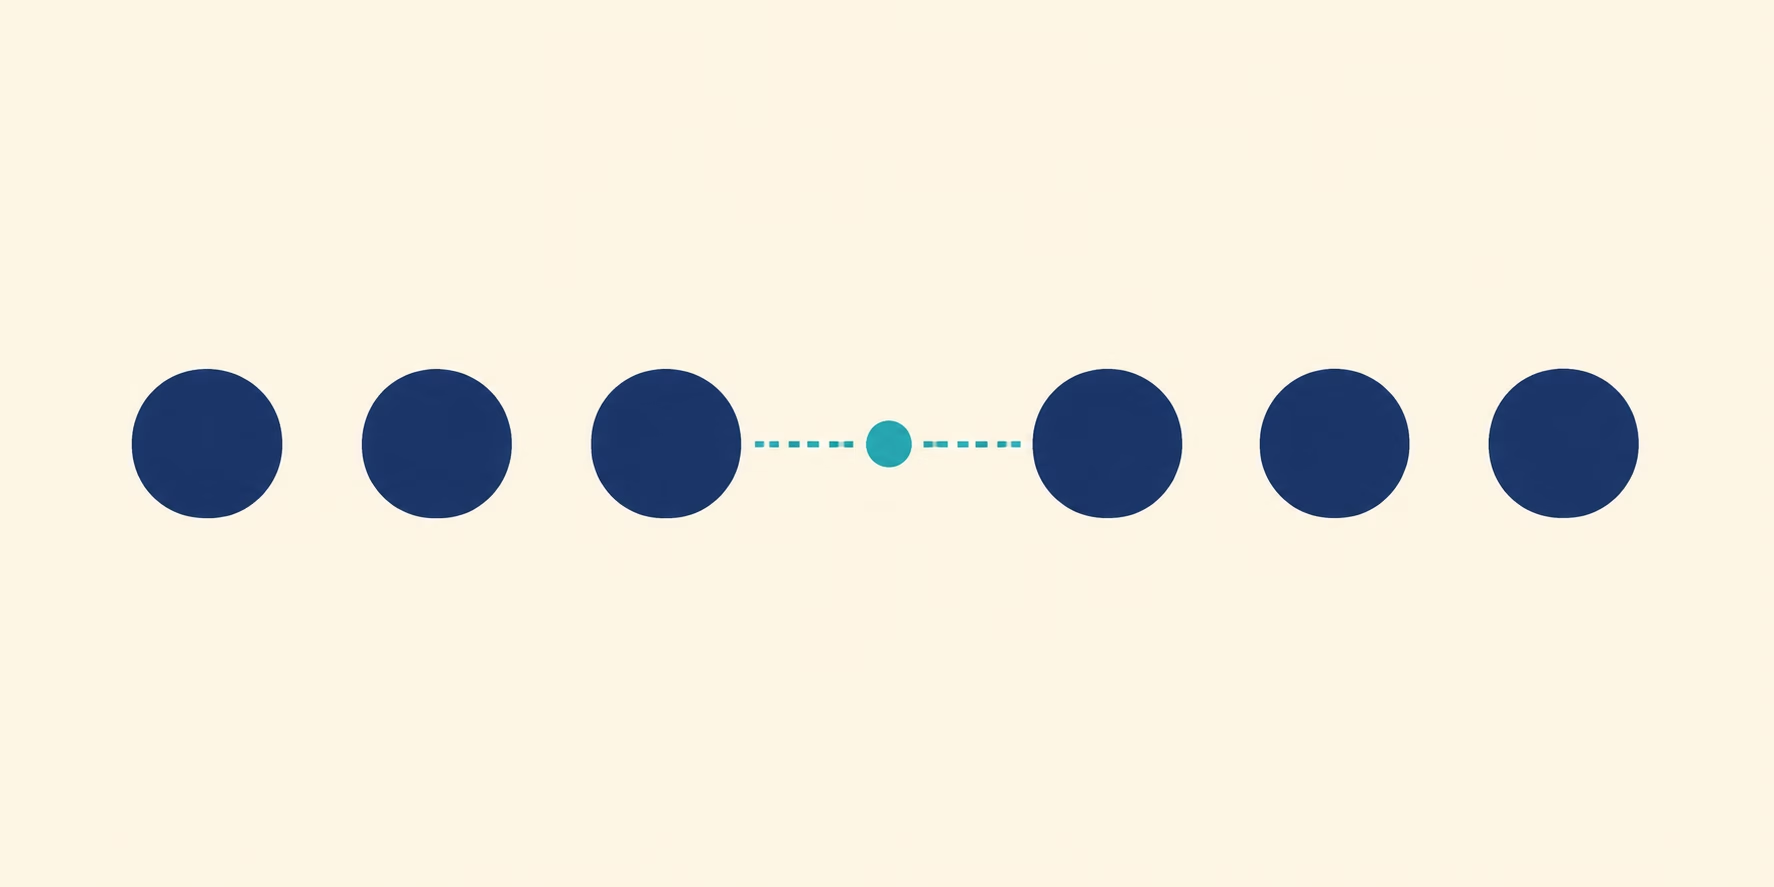
통계의 표준 계산 절차는 그 구간의 중간점인 (2.50 + 2.70) ÷ 2 = 2.60을 택한다. 세종대학교 강의자료 「제2장 자료의 통계적 측도」는 이 여섯 값을 예시로 들어 세 번째와 네 번째 값의 평균을 2.60으로 계산한다. OpenStax의 「3.1 Measures of Center」도 짝수 개 수치 자료에서는 두 가운데 값을 더해 2로 나누는 절차를 제시한다.
따라서 중앙값이 반드시 원자료에 포함된다는 말은 홀수 개 자료에는 맞지만, 짝수 개 수치 자료에는 맞지 않는다.
공식보다 먼저 확인할 네 가지
- 값의 차이가 의미 있는 수치 자료인지 확인한다.
- 결측값을 제외했다면 그 기준과 남은 유효값 수를 확인한다.
- 가중치가 있다면 각 행을 동일한 관측값처럼 취급하지 않는다.
- 가중치 없는 유효 원자료를 정렬한 뒤,
n/2번째와n/2+1번째 값을 평균낸다.
위 예시는 유효값 6개인 가중치 없는 원자료다. 계급 구간과 도수만 있는 표에서는 개별값을 알 수 없으므로 이 평균식을 그대로 적용할 수 없다. 세종대학교 자료도 계급의 하한, 누적도수, 계급폭, 해당 계급의 도수를 쓰는 별도 계산식을 제시한다. 이렇게 구한 값은 원자료의 가운데 두 관측값을 평균한 결과가 아니라 계급 안의 분포를 전제로 한 추정치다.
2.50
2.70
2.60
가중치가 있으면 누적가중치 50%를 찾는다
가중치가 표본의 대표 비중이나 지출 비중을 뜻한다면 행의 개수만 세어 두 가운데 값을 평균내지 않는다. 값을 작은 순서로 정렬하고 같은 값의 가중치를 합친 뒤, 전체 가중치를 100%로 환산해 누적한다. 일반적인 이산형 가중중앙값은 누적가중치가 처음 50%에 이르는 값이다. 호주 통계청의 가중중앙값 설명도 가격 변화를 가중치와 함께 정렬한 뒤 50번째 백분위수에 놓인 값을 선택한다.
예를 들어 값 10, 20, 30, 40의 가중치가 각각 10%, 20%, 50%, 20%라면 누적가중치는 10%, 30%, 80%, 100%가 된다. 처음 50%에 이르는 값은 30이므로 가중중앙값은 30이다. 같은 네 값을 가중치 없이 계산한 중앙값 (20 + 30) ÷ 2 = 25와 결과가 달라진다.
직접 계산할 때는 값과 가중치의 대응이 흐트러지지 않았는지, 가중치 합계가 100% 또는 같은 의미의 총합인지 먼저 확인한다. 누적가중치가 정확히 50%에서 끝나거나 보간 규칙이 따로 있는 자료라면 여기서 임의로 두 값을 평균내지 말고 해당 조사·통계의 산출 지침을 따른다. 가중치가 빈도인지 표본 보정값인지 알 수 없는 경우에도 계산을 멈추고 자료 설명서를 확인해야 한다.
숫자로 적힌 등급은 평균낼 수 있는 값인지 따져야 한다
만족도를 ‘불만족=1, 보통=2, 만족=3’으로 입력했다고 해서 1과 2의 차이와 2와 3의 차이가 같다고 단정할 수는 없다. 이 숫자가 순서만 표시하는 코드라면 산술평균의 전제가 없다. DePaul University의 「Analysis and Interpretation」도 순서형 자료에는 순위가 있지만 범주 사이 간격은 고정되지 않을 수 있다고 구분한다.
응답 6개에서 세 번째가 ‘보통’, 네 번째가 ‘만족’이라면 ‘2.5점’이라고 쓰기보다 가운데 두 범주가 보통과 만족이라고 밝히는 편이 정보 손실이 적다. 응답 분포나 범주별 누적비율을 함께 제시하면 어느 쪽에 얼마나 가까운지도 확인할 수 있다.
반대로 길이, 시간, 금액처럼 차이와 중간점이 의미 있는 수치라면 2.60처럼 관측되지 않은 중앙값을 그대로 쓸 수 있다. R의 median 함수 문서도 수치 벡터를 대상으로 하며, 짝수 길이의 정수 입력에서 소수 결과가 나올 수 있음을 설명한다.
두 가운데 수의 평균은 짝수 개 수치형 원자료에 적용하는 중앙값이다. 가중치가 없는 원자료인지, 가중 자료인지, 계급별 도수표인지 구분하면 같은 공식을 잘못 적용하는 일을 피할 수 있다.
중앙값을 구한 뒤 평균과 어느 쪽을 보고할지 고민된다면, 평균과 중앙값을 같은 자료로 계산한 비교 예시에서 전형적인 값과 전체 합계를 설명하는 값의 차이를 확인할 수 있다.