평균에서 4만큼 떨어진 값은 거리로만 보면 4다. 분산은 이를 16으로 바꾼다. 부호를 없애는 것이 목적이라면 절댓값으로도 충분한데, 통계학은 왜 제곱을 널리 사용할까?
“편차를 더하면 0이 되기 때문”이라는 설명은 출발점에 가깝다. 평균은 관측값의 균형점이므로 평균으로부터의 편차를 모두 더하면 0이 된다. 그러나 절댓값도 부호 상쇄를 막는다. 제곱을 택하면 합의 변동을 분해하고 공분산과 연결하기가 쉬워진다. 그 대가로 먼 관측값의 영향은 급격히 커진다.
절댓값도 산포를 잴 수 있다
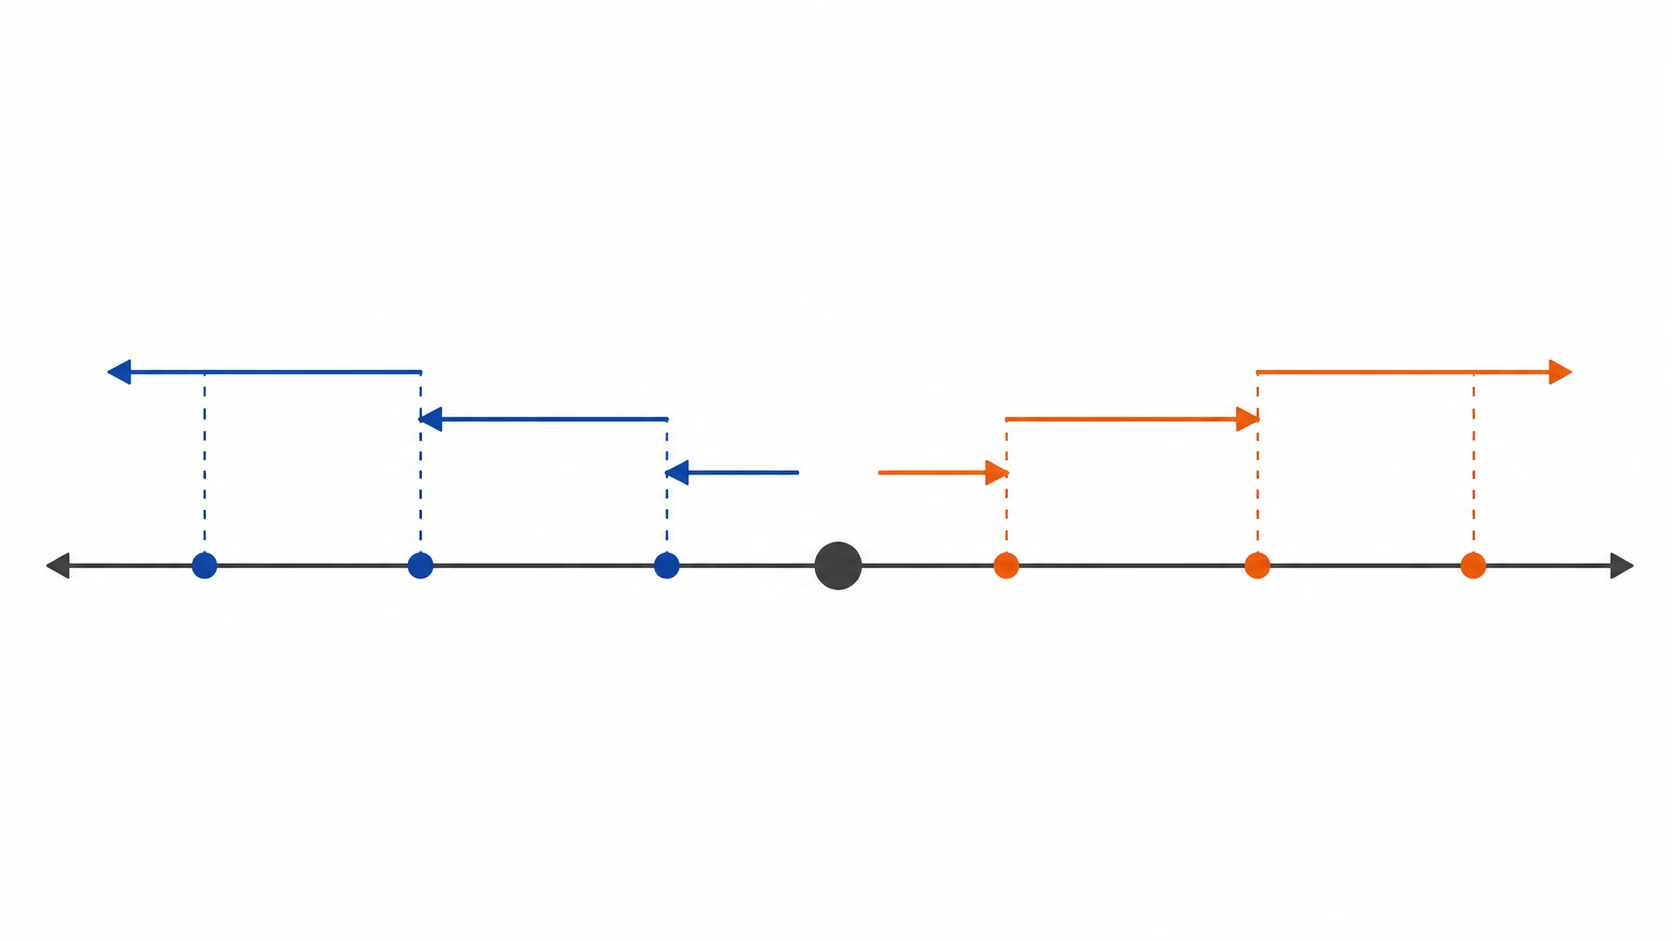
자료가 1, 2, 3이면 평균은 2이고 편차는 −1, 0, 1이다. 그대로 더한 결과는 0이지만, 모든 값이 평균과 같다는 뜻은 아니다. 절댓값을 적용하면 1, 0, 1이고 제곱해도 1, 0, 1이므로 두 방식 모두 산포를 표현한다.
콜로라도주립대와 몬태나주립대 연구진의 교육 자료도 평균절대편차와 표준편차를 평균에서 떨어진 거리를 서로 다른 방식으로 요약하는 두 측도로 설명한다. 절댓값은 제곱을 배우기 전에 잠시 사용하는 계산법이 아니라 독립적인 산포 측도다.
차이는 거리가 커질수록 뚜렷해진다. 평균에서 1, 2, 4만큼 떨어진 값을 절댓값으로 처리하면 1, 2, 4가 되지만, 제곱하면 1, 4, 16이 된다. 아래 차트는 각 거리를 두 함수에 대입한 자체 계산이며, 특정 자료의 빈도나 확률은 반영하지 않는다.
1
1
2
4
4
16
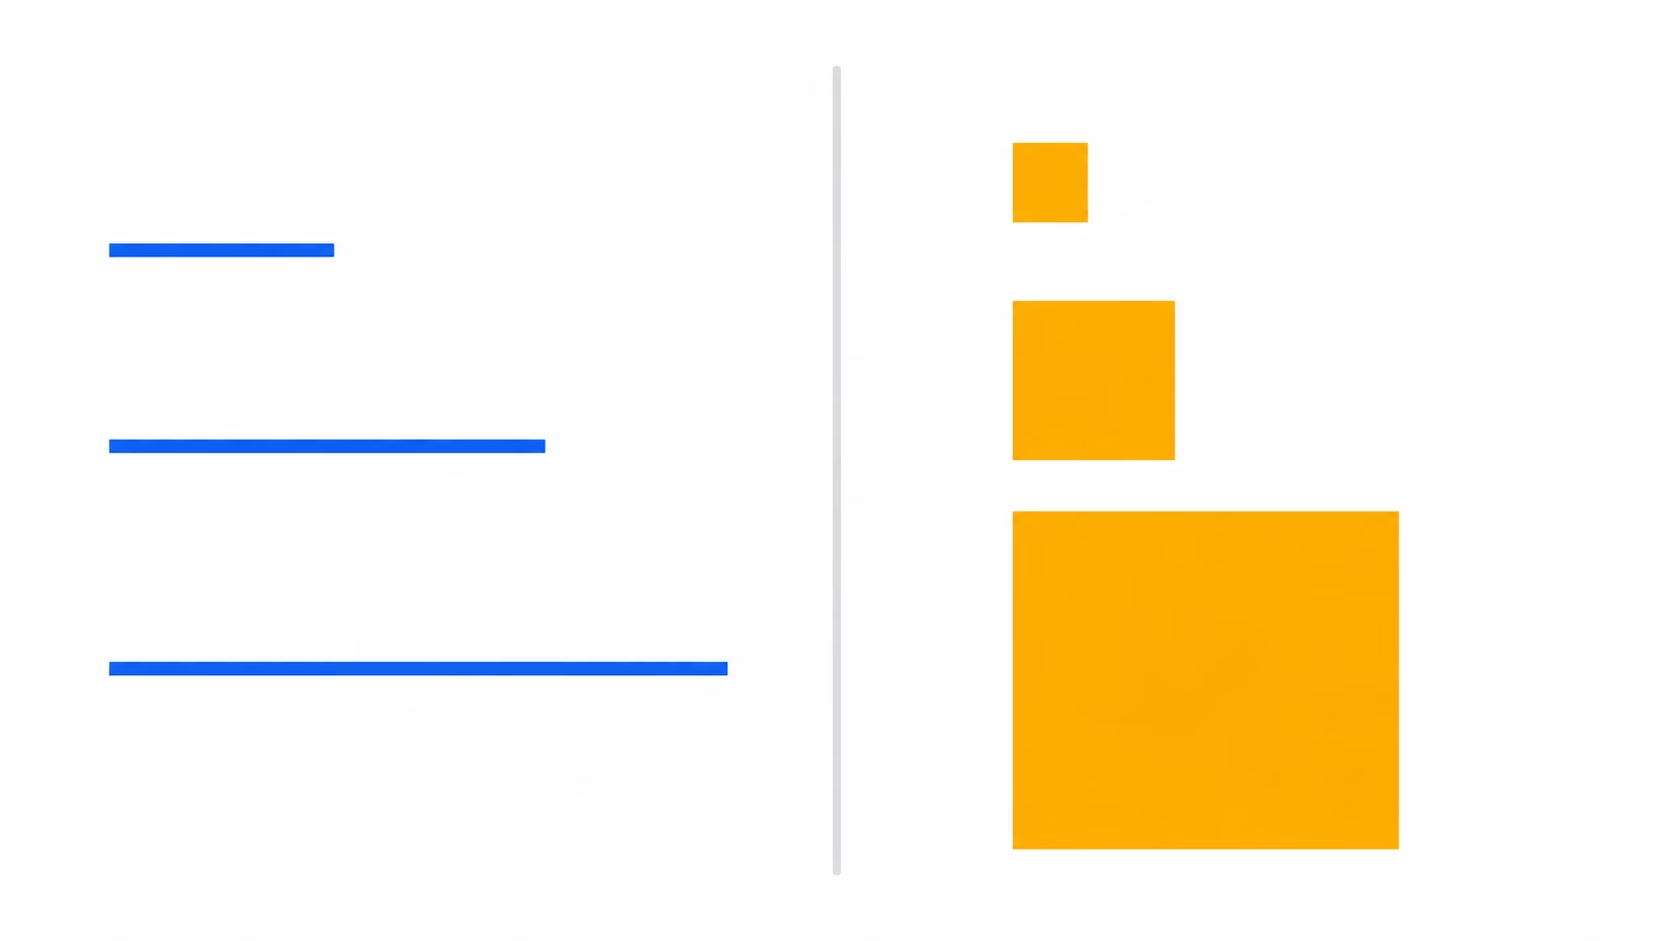
미국 국립표준기술연구소(NIST)의 산포도 지침도 제곱을 사용하면 평균에서 먼 관측값에 훨씬 큰 가중치가 붙는다고 설명한다. 제곱은 부호만 지우는 장치가 아니라 큰 편차를 더 강하게 반영하는 선택이다.
제곱은 합의 변동을 분해하기 쉽다
제곱의 중요한 장점은 여러 변수가 합쳐질 때 산포를 일정한 형식으로 분해할 수 있다는 데 있다. 유한한 분산을 가진 두 변수 X와 Y에는 다음 등식이 성립한다.
Var(X+Y) = Var(X) + Var(Y) + 2Cov(X,Y)
X와 Y가 비상관이면 공분산이 0이어서 합의 분산은 두 분산의 합이 된다. 독립이고 분산이 유한한 변수도 이 조건을 충족한다. 절대편차에는 일반적으로 같은 형태의 등식이 없다. UC 버클리 Data 88S 공개 교재가 절댓값도 가능한 산포 측도지만 합을 다룰 때 제곱거리가 유리하다고 설명하는 이유다.
분산과 공분산은 같은 행렬 안에서도 다룰 수 있다. 대각선에는 각 변수의 분산이, 나머지 칸에는 변수 쌍의 공분산이 놓인다. 펜실베이니아주립대 다변량 통계 강의가 제시하는 이 구조는 여러 측정값이 함께 움직이는 정도를 하나의 체계로 정리해 준다.
수식 전개도 간결하다. 분산 E[(X−μ)²]은 E(X²)−E(X)²으로 바꿀 수 있다. 제곱 손실은 매끄러워 최소화 문제에서 미분과 대수 전개로 해를 구하기 쉬운 경우가 많다.
그렇다고 절댓값을 계산하거나 최적화할 수 없는 것은 아니다. 절댓값 함수는 0에서 보통의 미분계수가 없지만 절대편차를 이용한 최적화는 가능하다. 정확한 차이는 ‘계산 가능 여부’가 아니라 제곱 손실이 닫힌 형태의 해와 단정한 분해식을 제공하는 경우가 많다는 데 있다.
제곱은 평균, 절댓값은 중앙값과 짝을 이룬다
하나의 중심값을 정해 각 관측값과의 제곱거리 합을 최소화하면 평균을 얻는다. 절대거리 합을 최소화하는 중심은 중앙값이다. 따라서 산포 측도와 중심값은 서로 무관하게 고르는 숫자가 아니라 같은 거리 기준에서 이어지는 짝이다.
자료 1, 2, 3, 4에 10을 더하면 평균은 4, 중앙값은 3이 된다. 평균 4를 기준으로 계산한 제곱편차합은 50이고 절대편차합은 12다. 계산식은 각각 (1−4)²+(2−4)²+(3−4)²+(4−4)²+(10−4)²과 |1−4|+|2−4|+|3−4|+|4−4|+|10−4|이다.
관측값 수 5로 나누면 모집단 분산은 10, 평균을 중심으로 한 평균절대편차는 2.4가 된다. 이 예시는 표본에서 모집단 분산을 추정하는 상황이 아니므로 n−1이 아니라 5로 나눴다. 중앙값 3을 기준으로 한 절대편차는 2, 1, 0, 1, 7이며 그 중앙값은 1이다. 이는 앞의 평균절대편차와 중심 및 집계 방식이 다른 측도다.
분산 10과 평균절대편차 2.4의 크기를 직접 비교해서 우열을 판단해서는 안 된다. 분산은 원자료 단위의 제곱이고 평균절대편차는 원래 단위이기 때문이다. 분산에 제곱근을 취한 모집단 표준편차는 약 3.16으로 원래 단위를 회복한다.
이상치 앞에서는 장점이 비용으로 바뀐다
큰 오차를 작은 오차보다 훨씬 심각하게 취급해야 한다면 제곱의 가중 방식이 분석 목적과 맞을 수 있다. 반대로 꼬리가 길거나 극단값이 있는 자료에서는 한두 관측값이 분산과 공분산을 크게 좌우한다. 거리 4는 거리 1보다 절댓값에서 4배 크지만 제곱값에서는 16배 크다.
NIST는 이런 분포에서 중앙값절대편차나 사분위범위가 표준편차보다 안정적일 수 있다고 설명한다. 표준편차는 정규분포에 가까운 자료에서 합리적인 선택이지만, 분포 형태와 극단값을 확인하지 않은 채 전형적인 거리로 해석하면 오해하기 쉽다.
‘MAD’라는 약어도 문맥에 따라 확인해야 한다. 앞의 대학 교육 자료에서는 평균으로부터 절대거리의 평균인 mean absolute deviation을 뜻한다. 강건통계와 일부 통계 소프트웨어에서는 각 관측값과 중앙값 사이 거리의 중앙값인 median absolute deviation을 가리킨다. 두 측도는 중심도, 집계 방법도 다르다.
절대편차와 제곱편차가 언제나 대체 관계인 것도 아니다. 캐나다 통계청의 개정 통계 공식 문서는 평균절대개정, 중앙값절대개정, 분산과 표준편차를 함께 제시한다. 전형적인 오차가 얼마나 큰지와 큰 오차까지 강하게 반영한 변동이 어느 정도인지는 서로 다른 질문이기 때문이다.
분포와 분석 목적에 맞춰 골라야 한다
자료가 대체로 대칭이고 합의 변동이나 공분산 구조를 다뤄야 한다면 평균과 분산·표준편차 조합이 편리하다. 다만 호주 통계청의 산포도 안내가 제시하는 평균 주변의 표준편차 범위 해석은 정규분포를 전제로 한다. 다른 모양의 분포에 같은 비율을 기계적으로 적용해서는 안 된다.
자료가 심하게 비대칭이거나 이상치가 많다면 중앙값과 중앙값절대편차 또는 사분위범위를 먼저 검토할 수 있다. 평균에서 떨어진 거리를 원래 단위로 직접 설명하려는 목적에는 평균절대편차도 쓸 수 있다. 어떤 측도를 택하든 히스토그램이나 상자그림을 함께 보면 숫자 하나가 감추는 비대칭과 극단값을 확인하기 쉽다.
분산이 제곱을 사용하는 이유는 하나가 아니다. 부호 상쇄를 막는 데에는 절댓값도 충분하지만, 제곱은 합의 분산과 공분산을 같은 구조로 다루고 최소화 문제를 전개하기 편하게 만든다. 대신 먼 값의 영향이 빠르게 커진다. 분산은 유일한 산포 측도가 아니라 평균 중심의 분석에 특히 잘 맞는 선택이다.
참고 자료
- 미국 국립표준기술연구소(NIST), 「1.3.5.6. Measures of Scale」
- UC Berkeley Data 88S, 「Variance and Standard Deviation」
- Penn State University, 「Measures of Central Tendency, Dispersion and Association」
- Colorado State University·Montana State University 연구진, 「Variability: Mean Absolute Deviation and Standard Deviation」
- 호주 통계청(ABS), 「Measures of spread」
- 캐나다 통계청, 「Appendix C: Formulas for calculating revision summary statistics」