표준편차가 3이라고 해서 곧바로 변동이 크다고 말할 수는 없다. 측정 단위와 평균, 비교 대상의 기간·측정 방식을 함께 봐야 한다. 분산과 표준편차는 계산의 끝이 아니라 자료가 평균 주변에 어떻게 퍼져 있는지 읽는 출발점이다.
분산은 제곱 단위, 표준편차는 원래 단위다
각 값에서 평균을 뺀 편차를 제곱해 계산한 값이 분산이고, 그 제곱근이 표준편차다. 길이를 cm로 쟀다면 분산은 cm², 표준편차는 cm로 표시된다. NIST의 산포 지표 해설도 표본 표준편차가 표본분산의 제곱근이며 원래 측정 단위를 갖는다고 설명한다.
계산 과정에서는 분산을 쓰더라도 결과를 전달할 때는 표준편차가 더 직접적이다. ‘분산 9시간²’보다 ‘표준편차 3시간’이 관측값의 퍼짐을 읽기 쉽다.
표준편차가 분산보다 이상치에 덜 민감하다는 설명은 적절하지 않다. 둘 다 편차를 제곱하는 계산에 기반하고, 표준편차는 분산에 제곱근을 적용한 값이다. 극단값이 들어오면 두 지표 모두 크게 영향을 받는다.
평균이 같아도 자료의 모습은 달라진다
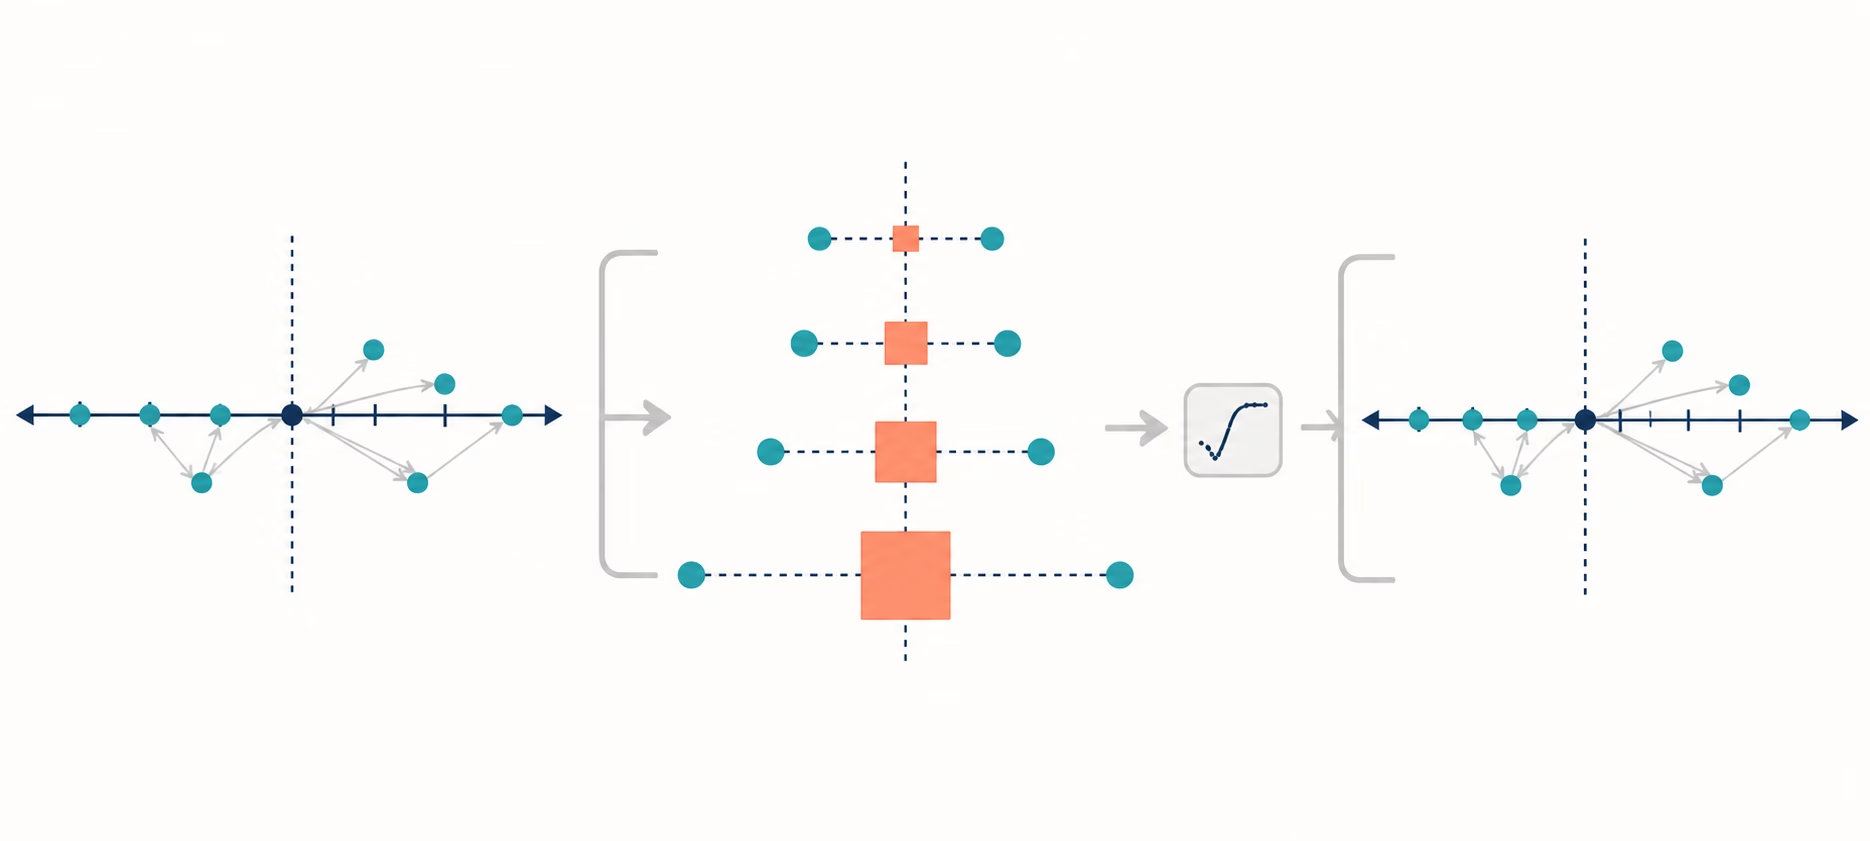
평균이 모두 10인 가상 자료 두 개를 보자. 분산은 각 값과 평균의 차이를 제곱해 5개로 나누는 모집단 방식으로 계산했다.
- 자료 A: 8, 9, 10, 11, 12 → 분산 2, 표준편차 약 1.41
- 자료 B: 4, 7, 10, 13, 16 → 분산 18, 표준편차 약 4.24
평균만 보면 두 자료는 모두 10이다. A는 10 근처에 모여 있지만 B는 더 넓게 퍼져 있다. 이 수치로 말할 수 있는 것은 같은 단위·기간·측정 방식에서 B의 관측값 산포가 더 크다는 점이다. B의 품질이 낮다거나 원인이 무엇인지는 표준편차만으로 판단할 수 없다.
계산 뒤에는 네 가지를 확인한다
- 전수 자료인지 표본인지 확인한다. 더 큰 집단을 대표하려 뽑은 표본의 분산과 표준편차는 보통 분모에 n 대신 n−1을 쓴다. 같은 데이터를 두 방식으로 계산했다면, 계산 방식을 구분하지 않은 채 값을 나란히 비교하면 안 된다.
- 표준편차는 원래 단위의 문장으로 바꿔 읽는다. 표준편차 3은 측정값이 시간이라면 3시간, 길이라면 3cm라는 뜻이다.
- 비교 대상은 평균·단위·기간·측정법이 같은 자료다. 평균 수준이 크게 다른 두 자료는 절대 표준편차만으로 상대적 산포를 판단하기 어렵다.
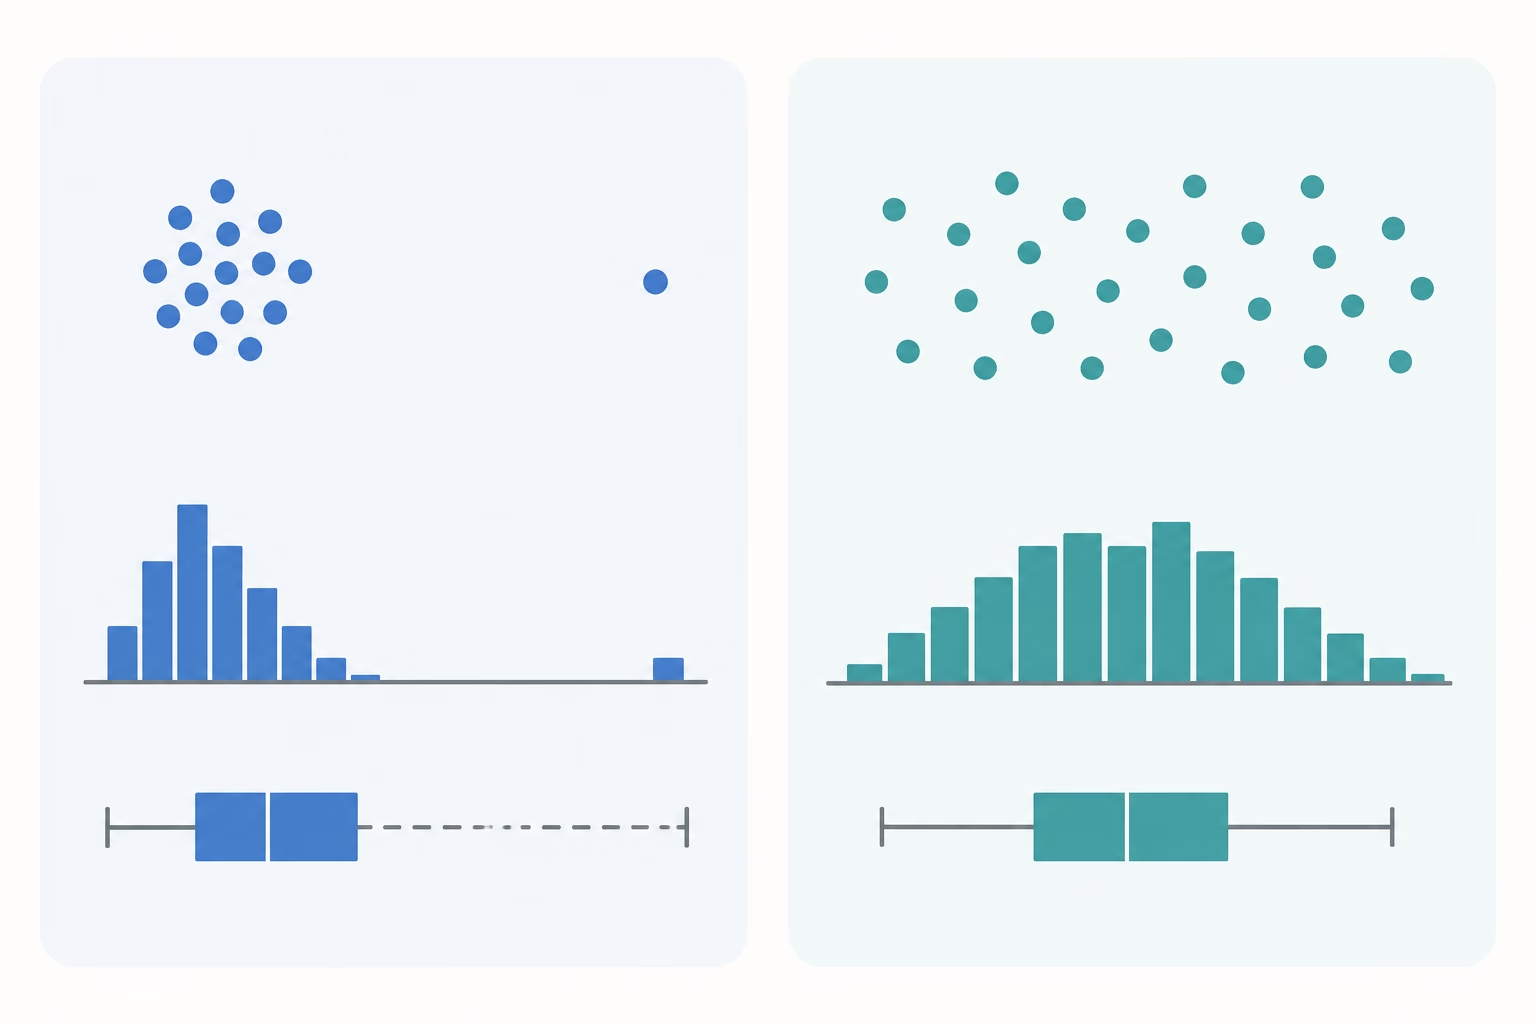
- 분포 모양은 히스토그램, 정렬된 값, 사분위수로 살핀다. 한두 개의 극단값이 표준편차를 키운 경우와 대부분의 값이 넓게 퍼진 경우는 구분해야 한다.
평균±표준편차 안의 비율은 원자료에서 센다
평균±표준편차를 곧바로 ‘정상 범위’나 일정한 관측 비율로 읽으면 안 된다. 그 안에 실제로 몇 개가 드는지는 분포 모양에 따라 달라진다. NIST의 산포 지표 해설도 히스토그램이나 확률그림에서 정규분포로 근사할 수 있는지 확인한 뒤 표준편차를 산포 지표로 쓰도록 설명한다.
같은 평균과 표준편차라도 구간 안의 비율은 같지 않다. 모집단 방식으로 계산한 가상 자료 A가 8, 8, 12, 12라면 평균은 10, 표준편차는 2이고 네 값 모두 평균±표준편차 구간인 8 이상 12 이하에 들어가므로 비율은 100%다. 자료 B를 10−2√2, 10, 10, 10+2√2로 두면 평균과 모집단 표준편차는 똑같이 10과 2지만, 8 이상 12 이하에 드는 값은 네 개 중 두 개여서 50%다. 이 가상 계산은 특정 비율이 보편적이라는 뜻이 아니라, 평균과 표준편차만으로 실제 포함 비율을 정할 수 없음을 보여준다.
원자료가 있다면 같은 모집단·표본 정의로 평균과 표준편차를 계산하고, 평균−표준편차와 평균+표준편차를 경계로 정한 뒤 그 안에 든 관측값 수를 전체 관측값 수로 나눈다. 원자료가 없다면 표본 수와 분포 그림, 사분위수 같은 정보 없이 평균±표준편차 안의 비율을 확정하지 않는다.
평균이 다른 자료는 CV를 조건부로 쓴다
같은 종류의 측정값인데 평균 수준이 다르면 변동계수(CV)를 보조로 볼 수 있다. CV는 표준편차를 평균으로 나눈 비율이다. 평균 10, 표준편차 2인 자료의 CV는 20%다. 평균 100, 표준편차 10인 자료의 CV는 10%다. 절대 산포는 뒤쪽이 더 크지만, 평균에 대한 상대적 산포는 앞쪽이 더 크다.
CV가 모든 비교에 맞는 것은 아니다. NIST의 변동계수 설명은 평균이 0에 가깝거나 음수이면 CV가 불안정하거나 해석하기 어렵다고 밝힌다. 의미 있는 0을 갖는 비율척도에서 쓰는 것이 적절하므로, 섭씨온도처럼 0이 임의 기준인 척도에는 CV로 순위를 매기지 않는 편이 낫다.
평균 옆의 ±가 SD인지 SE인지 확인한다
평균 옆의 ±값이 언제나 관측값의 퍼짐을 뜻하지는 않는다. 표준편차(SD)는 개별 관측값이 평균 주변에 얼마나 퍼졌는지 나타낸다. 반면 표준오차(SE)는 표본평균이 모집단 평균을 얼마나 정밀하게 추정하는지와 관련된 값이다. 표준편차와 표준오차의 용도를 구분한 해설도 이 차이를 설명한다.
같은 자료에서도 표본 수가 늘면 SE는 작아질 수 있다. 그렇다고 관측값 자체의 산포인 SD가 그만큼 작아진 것은 아니다. 보고서의 ‘평균 ± 2’를 읽기 전에는 SD인지 SE인지와 표본 수를 함께 확인해야 한다.
긴 꼬리나 이상치가 보이면 보완 지표를 붙인다
값이 한쪽으로 길게 늘어지거나 이상치가 뚜렷하면 평균과 표준편차만으로 ‘대부분’의 모습을 설명하기 어렵다. NIST의 산포 지표 해설은 이런 자료에서 중앙값 절대편차(MAD)나 사분위범위(IQR) 같은 강건한 산포 지표를 함께 검토하도록 안내한다.
표준편차는 작을수록 무조건 좋고 클수록 무조건 나쁜 점수가 아니다. 같은 조건에서 평균 주변의 퍼짐을 원단위로 보여주는 값이다. 표본 여부와 단위를 확인하고, 비교 조건을 맞춘 뒤 분포 모양까지 보면 표준편차 하나로 집단의 안정성이나 우열을 단정하는 일을 줄일 수 있다.