[카테고리:] 배경지식
분산은 왜 제곱할까? 절댓값을 쓰지 않는 이유
평균에서 4만큼 떨어진 값은 거리로만 보면 4다. 분산은 이를 16으로 바꾼다. 부호를 없애는 것이 목적이라면 절댓값으로도 충분한데, 통계학은 왜 제곱을 널리 사용할까?
1,000명에게 물었는데 못 믿는 설문이 되는 이유
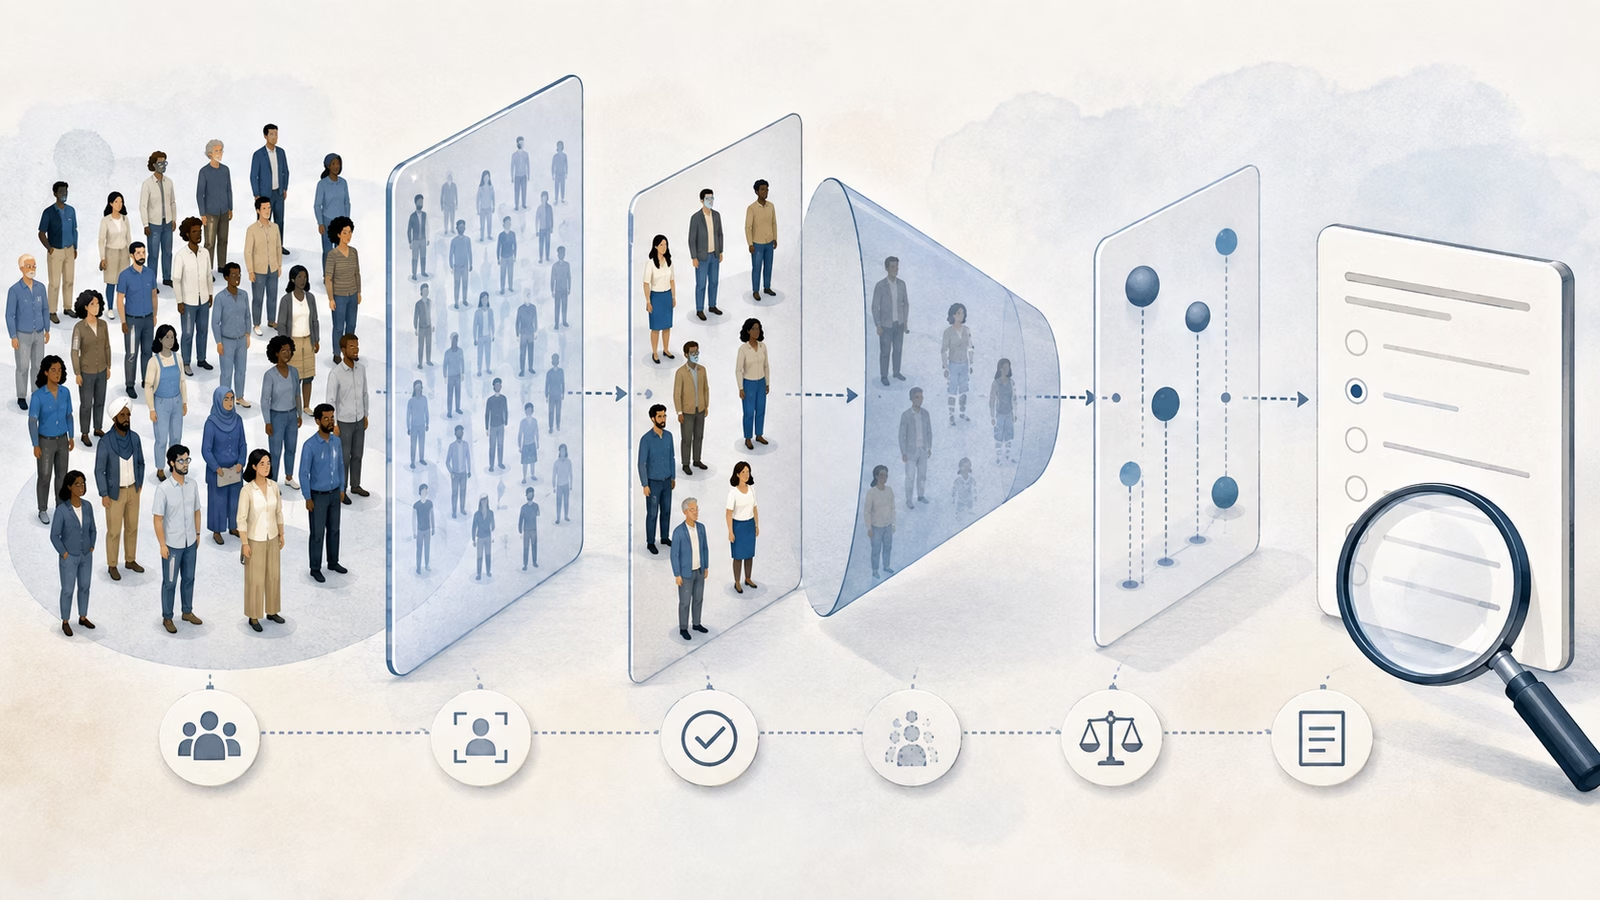
“성인 1,000명에게 물었다”거나 “95% 신뢰수준에서 표본오차는 ±3.1%포인트다”라는 설명은 정밀해 보인다. 그러나 이 숫자는 조사 대상이 어떻게 뽑혔는지, 누가 응답하지 않았는지, 무엇을 어떻게 물었는지까지 보증하지 않는다.
표준편차 3이면 큰 걸까? 숫자만 보면 놓치는 것
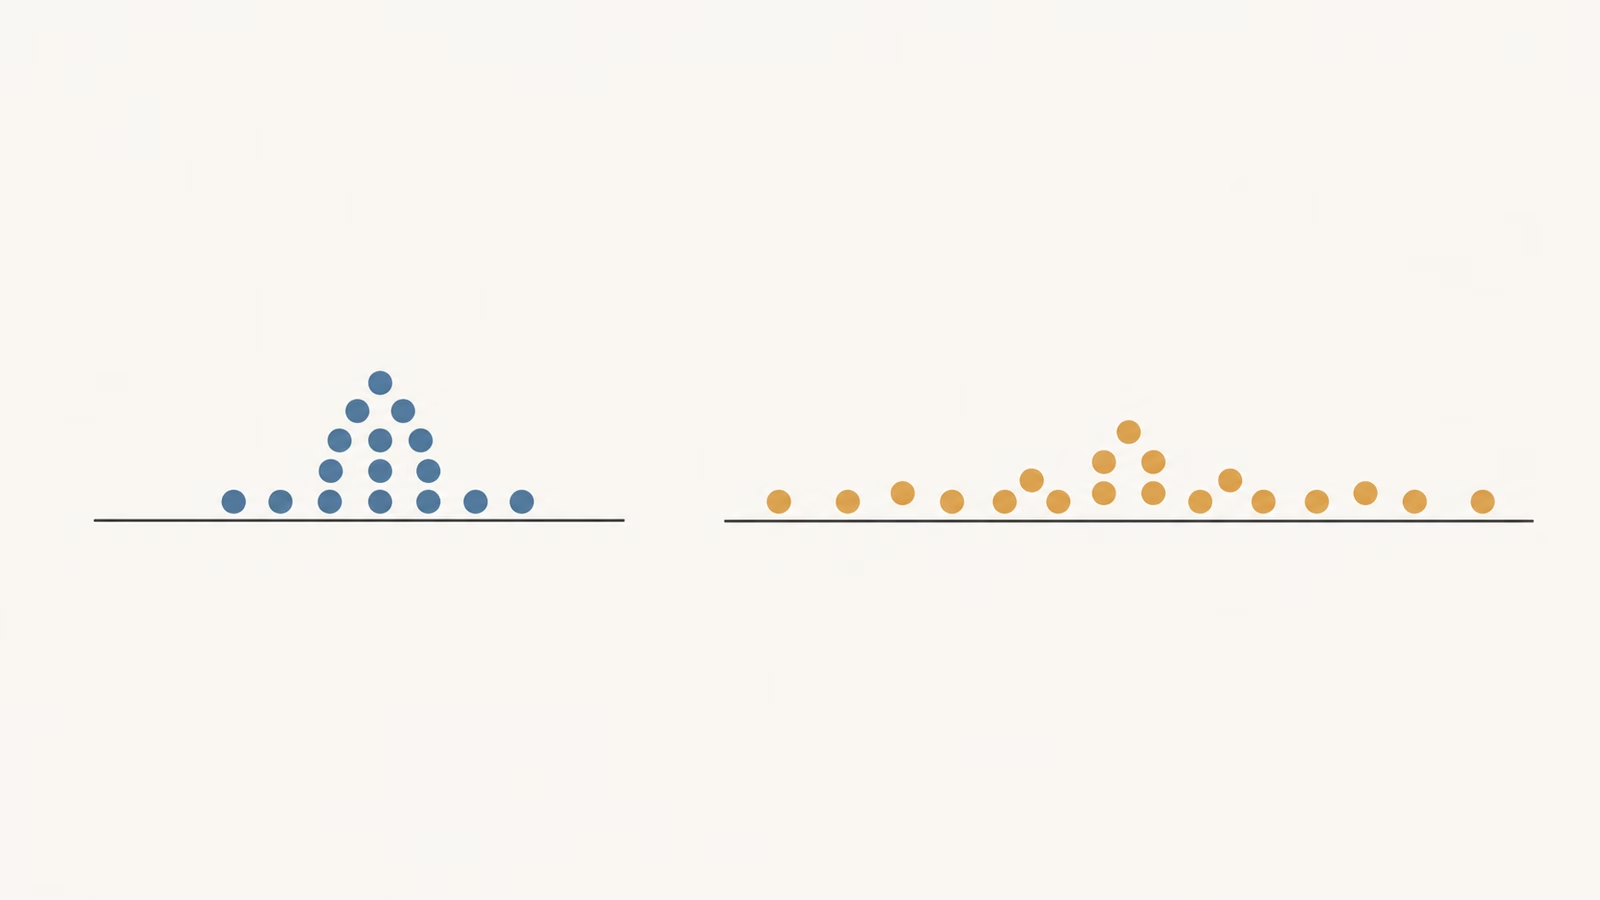
표준편차가 3이라고 해서 곧바로 변동이 크다고 말할 수는 없다. 측정 단위와 평균, 비교 대상의 기간·측정 방식이 먼저다. 분산과 표준편차는 계산의 끝이 아니라 자료가 평균 주변에 어떻게 퍼져 있는지 읽는 출발점이다.
그래프가 0부터 시작하지 않으면 무조건 왜곡일까
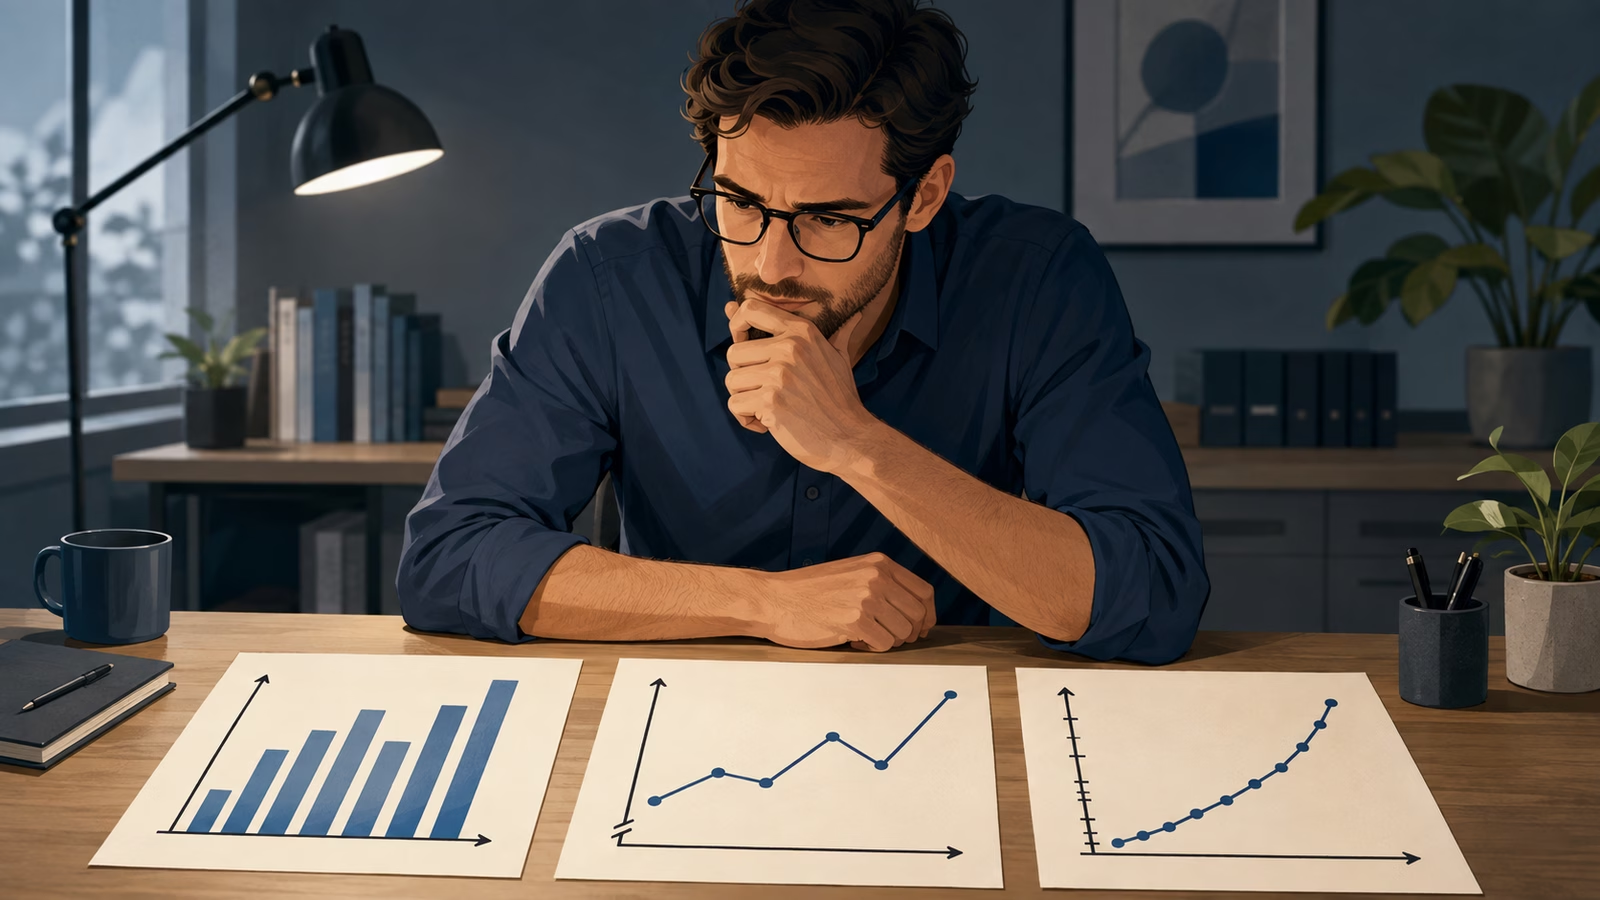
그래프의 y축이 0에서 시작하지 않아도 곧바로 왜곡이라고 단정할 수는 없다. 막대처럼 길이가 절대 크기를 나타내는 차트와 선처럼 변화의 흐름을 보여 주는 차트에는 서로 다른 기준이 필요하다.
창업이 늘면 살아남는 기업도 늘까? 통계의 분모 차이
창업기업 수가 늘어도 새 기업의 생존 가능성이 높아졌다고 말할 수는 없다. 반대로 창업이 줄어든 해에 5년 생존율이 올랐다는 사실만으로 창업 환경이 개선됐다고 단정하기도 어렵다. 두 지표가 세는 기업과 기간이 다르기 때문이다.
평균과 중앙값 차이, 숫자 5개로 계산하고 비교하기
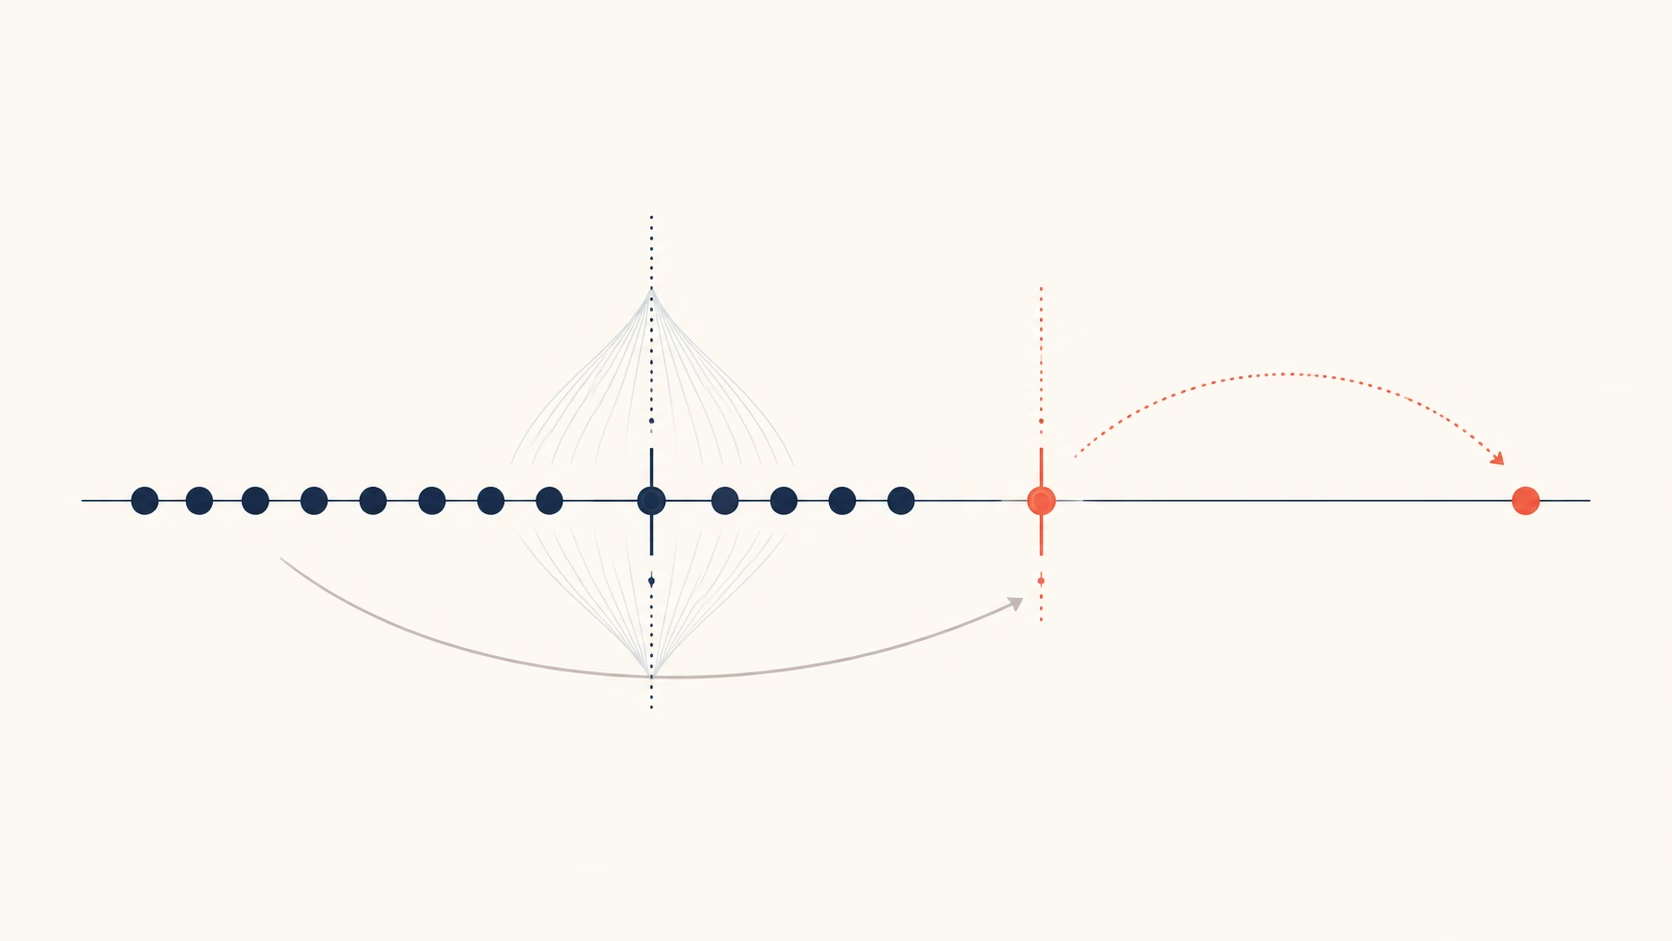
평균은 합계를 개수로 나눈 값, 중앙값은 정렬한 가운데 값이다. 10·10·10·10·60 예시로 계산법과 큰 값의 영향, 각각 쓸 때를 비교하고 관측 단위와 0·결측값 처리 기준까지 확인한다.
MZ세대 소비 통계, 조사마다 말이 다른 이유
‘MZ세대는 가치소비를 하고 온라인 구매를 선호한다’는 설명에는 한 가지 문제가 있다. 조사마다 MZ세대의 출생연도와 당시 나이가 다르고, 구매 의향과 실제 이용 경험도 같은 증거처럼 섞이기 때문이다.
모니터 PPI 비교, 27인치 QHD·4K와 32인치 4K
27인치 QHD 108.8, 27인치 4K 163.2, 32인치 4K 137.7 PPI를 비교한다. 34인치 울트라와이드의 표시 폭, 배율 뒤 작업 공간, 목표 출력 모드 확인 순서도 정리했다.
캐시 지우려다 로그아웃됐다? 쿠키와 다르게 지우는 법
웹사이트가 이전 화면으로 보이거나 로그인이 반복될 때, 캐시와 쿠키를 한꺼번에 지우라는 안내를 받기 쉽다. 그러나 두 데이터는 저장하는 정보와 삭제 뒤의 영향이 다르다.
JPG·PNG·WebP 차이, 용량·투명도·호환성 비교
JPG·PNG·WebP의 용량·투명도·호환성을 비교한다. 같은 원본을 직접 변환한 결과와 샘플 파일을 내려받아 내 용도에 맞는 형식을 확인할 수 있다.